arXiv preprint 2025 · preprint
Video-LMM Post-Training: A Deep Dive into Video Reasoning with Large Multimodal Models
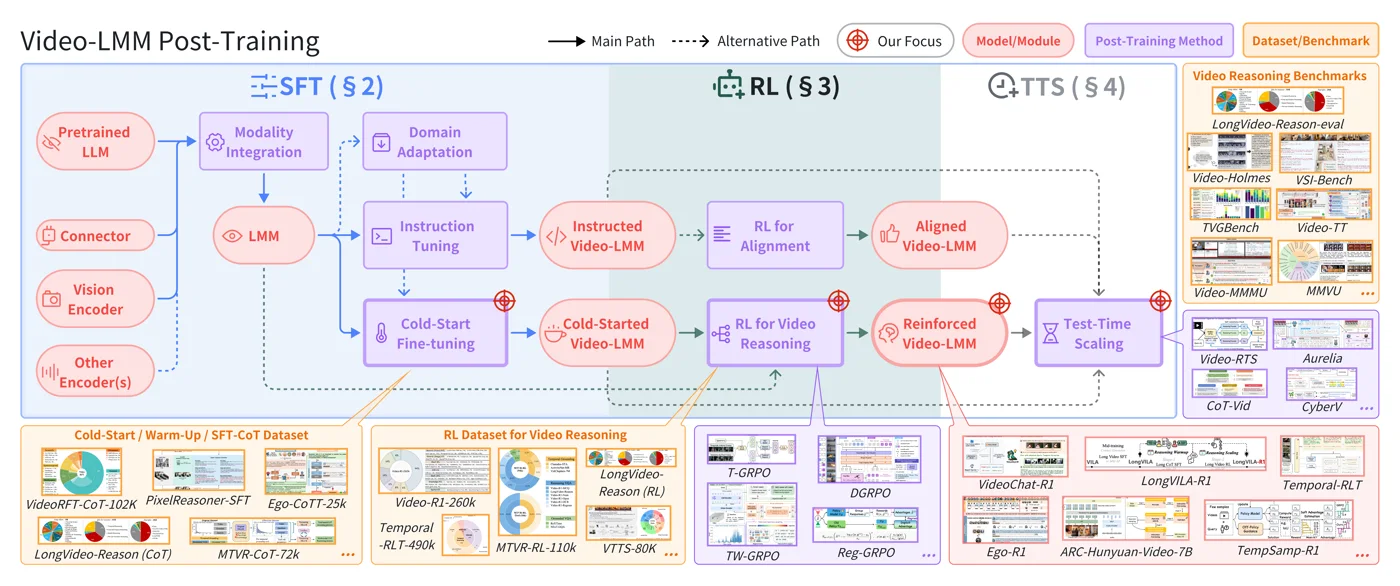
Unified treatment of supervised fine-tuning, reinforcement learning, preference optimization and test-time scaling for Video-LMM reasoning.
My part. Co-authored a comprehensive survey of post-training methods for video-LLMs (chain-of-thought SFT, RLVR, test-time scaling).
Unified treatment of supervised fine-tuning, reinforcement learning, preference optimization and test-time scaling for Video-LMM reasoning.