AAAI Demonstration Track 2026, Best Demonstration Award Runner-up
Caption Anything in Video: Fine-grained Object-centric Captioning via Spatiotemporal Multimodal Prompting
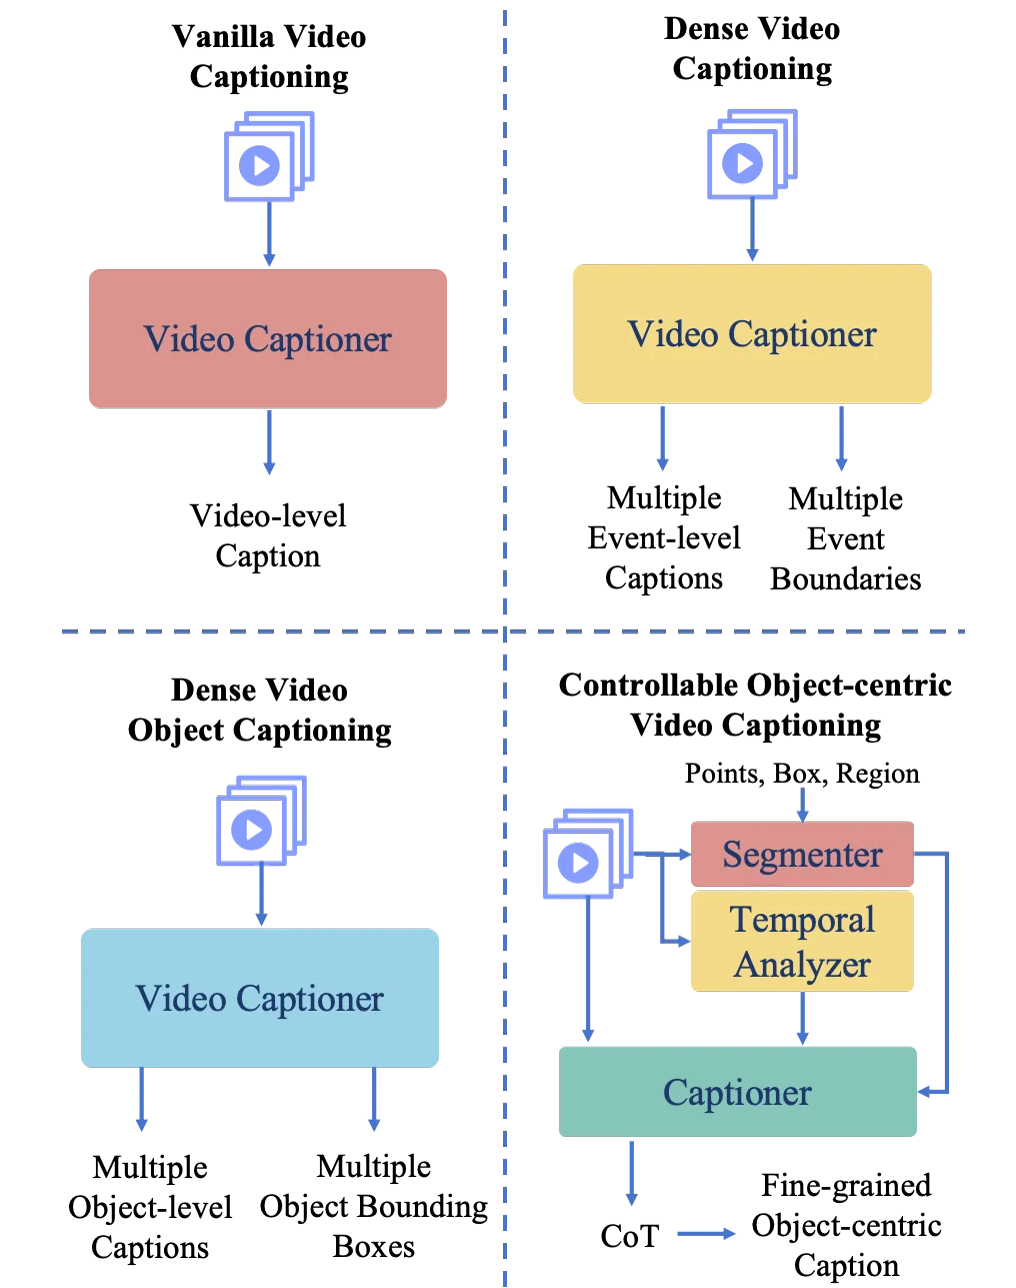
Training-free object-centric video captioning with SAMURAI segmentation, TRACE-Uni temporal analysis and InternVL-2.5 captioning.
Training-free object-centric video captioning with SAMURAI segmentation, TRACE-Uni temporal analysis and InternVL-2.5 captioning.